Points clés
- Améliore la qualité des exigences ; mauvaises exigences → mauvais tests. Toujours.
- L'auto-réparation sans journalisation est une usine à défauts silencieuse prête à exploser.
- Défaillances des clusters ML ; les humains prennent toujours les décisions.
- La gouvernance fait passer l’IA à l’échelle ; sans elle, 63 % des initiatives s’arrêtent au stade pilote.
- Sauter des étapes entraîne un effondrement de la confiance dès que la première décision d’IA provoque une défaillance non détectée.
- Réduire de 22 % les défauts échappés est une stratégie ; écrire 500 tests d’IA est une vanité.
Contexte et impact — l’opportunité
Les organisations qui adoptent avec succès l’IA dans la QA constatent des gains significatifs : des cycles plus rapides, une meilleure détection des défauts et un ROI mesurable en quelques mois. Pourtant, la majorité stagne au stade pilote. Non pas parce que la technologie est insuffisante, mais parce qu’elles ont sous-estimé la couche de gouvernance. Elles n’ont pas précisé quelles décisions doivent revenir aux humains et lesquelles peuvent être automatisées en toute sécurité.
Il y a un peu plus d’un an, si vous m’aviez dit qu’une partie de mon travail de conception de tests commencerait par une conversation plutôt que par un tableau vierge, j’aurais été sceptique. J’avais assisté à suffisamment de démonstrations de fournisseurs où l’outil fonctionnait parfaitement sur une application de tâches, mais échouait dès qu’on s’approchait de notre véritable système. Je suis donc arrivé à cette vague d’outils d’IA en m’attendant à être déçu.
J’ai été présent à certains endroits. Mais pas partout. Certaines choses ont réellement changé ma façon de passer la journée, et quelques-unes ont fait gagner de véritables heures à l’équipe dès le premier mois. Ce qui suit est un compte-rendu pratique des domaines où l’IA générative et l’apprentissage automatique s’imposent aujourd’hui dans l’ingénierie qualité, là où ils ne sont pas encore fiables, et comment je conseillerais une équipe à déployer cela sans créer une nouvelle catégorie de défauts à traquer.
Voici le cadre. Besoin d’une aide experte ? →Consultez-nous
Le rôle évolue, il ne disparaît pas
Commençons par aborder la question angoissante, car tout le monde dans une équipe QE y pense. Non, l’IA n’a pas rendu les ingénieurs qualité obsolètes, et je ne vois pas cela changer de sitôt. Ce qu’elle a fait, c’est réduire la part des tâches mécaniques : le localisateur que vous devez mettre à jour pour la quatrième fois ce sprint, les vingt cas limites presque identiques que vous écririez à la main, les deux cents échecs de pipeline que vous faisiez défiler un lundi pour en trouver les trois importants.
Ce n’est pas le travail auquel j’étais particulièrement attaché. Il reste la partie qui nécessite réellement une personne : décider ce qui mérite d’être testé, juger si le comportement devant vous est correct, comprendre pourquoi un cas limite particulier existe parce que vous vous souvenez de l’incident qui l’a créé. En fait, le travail est devenu plus intéressant et un peu plus exigeant, car bien revoir les résultats de l’IA exige de connaître parfaitement le domaine.
Où cela fonctionne
Conception des tests et génération de cas
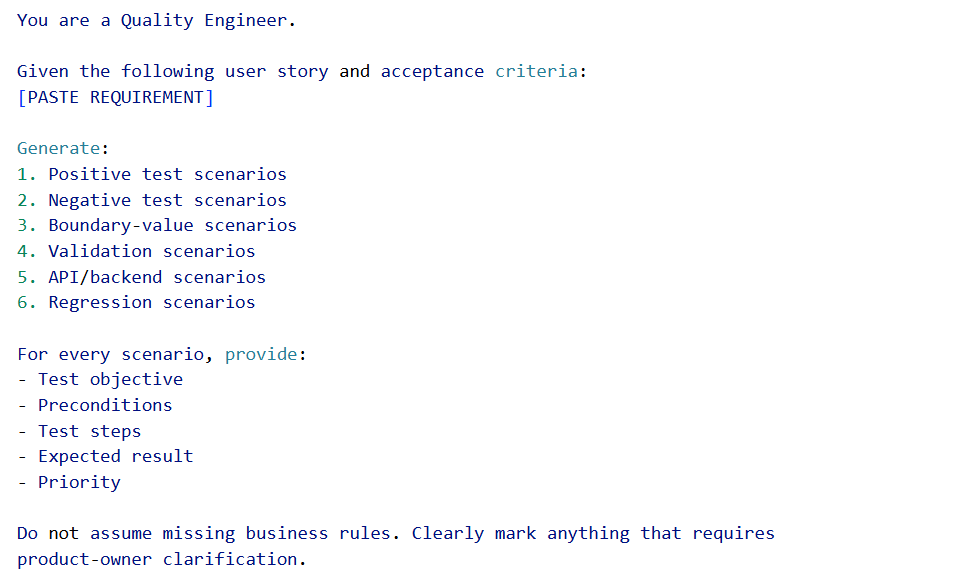
C’est celle qui m’a le plus surpris. Je peux gérer un modèle de langage, une user story avec des critères d’acceptation corrects, ou un contrat d’API, et obtenir en retour un éventail de scénarios positifs, négatifs et limites dans le temps qu’il me faut pour refaire mon café. Peut-être un tiers d’entre eux sont des choses auxquelles j’aurais pensé de toute façon. Un autre tiers mérite d’être conservé et j’aurais peut-être manqué un ou deux points sous la pression du temps. Le reste, je le rejette. C’est un partenaire de brainstorming qui ne se fatigue jamais et ne devient jamais défensif lorsque vous refusez ses idées.
Le piège, et c’est un gros : cela ne fonctionne bien que lorsque les exigences sont bien rédigées. Fournissez-lui une histoire vague et vous obtenez en retour des inepties vagues et assurées. L’IA amplifie la qualité que vos spécifications possèdent déjà. À plusieurs reprises, l’exercice de tenter de générer des tests à partir d’une histoire a mis en évidence que l’histoire elle-même manquait de détails, ce qui était utile en soi.
Exemple — Génération de test de prompt
Automatisation autoréparatrice
Quiconque a maintenu une vaste suite d’interface utilisateur sait que la plupart des échecs ne sont pas réels. Un localisateur a changé, une d’encapsulation a été ajoutée, quelqu’un a renommé une classe CSS. Le test est en échec, mais la fonctionnalité est correcte. Les frameworks récents identifient désormais les éléments grâce à plusieurs signaux simultanément ; le texte visible, le rôle d’accessibilité, la position, les étiquettes voisines ; et corrigent discrètement le localisateur lorsque le DOM se modifie en dessous.
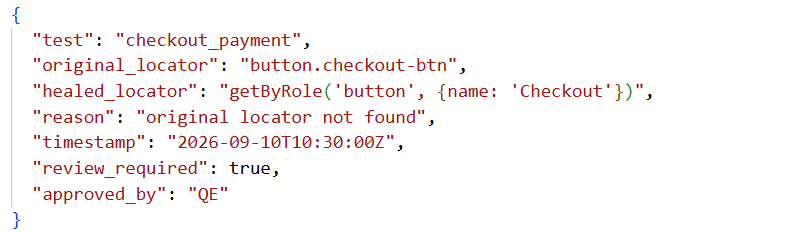
Lorsqu’elle fonctionne, cela réduit considérablement le temps de maintenance. Mais je tiens à être prudent ici, car il existe un mode de défaillance pire qu’un test cassé. Si un test se « répare » silencieusement autour d’une régression réelle, vous obtenez alors un build vert qui masque un défaut réel. La règle dans mon équipe est donc simple : chaque action de réparation est enregistrée, apparaît dans le rapport, et fait l’objet d’une vérification humaine lors de notre revue hebdomadaire. Une réparation qui se produit de manière invisible est une responsabilité, pas une fonctionnalité.
Exemple — Enregistrement d’audit auto-réparateur
Gestion des défaillances et détection des tests instables
L’apprentissage automatique est efficace pour repérer des motifs à travers des milliers d’exécutions, ce qui correspond exactement à la nature de ce problème. L’outil regroupe les échecs par cause racine probable et signale les tests dont l’historique de réussite/échec semble non déterministe. Plutôt que d’ouvrir quatre-vingts échecs, j’ouvre les quatre groupes identifiés, et généralement, le problème réel se trouve dans le premier.
Génération de données de test
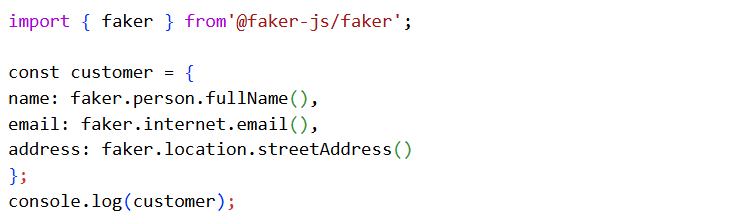
Nous fonctionnons sous des contraintes de confidentialité qui rendent l’utilisation de données de production impossible dans la plupart des cas. Les modèles génératifs peuvent créer des enregistrements synthétiques — noms, adresses, historiques de transactions — qui suivent des distributions similaires à celles de la production sans contenir aucune information réelle sur les clients. Ce n’est pas parfait, et il faut toujours veiller à l’intégrité référentielle entre les tables, mais c’est bien meilleur que les ensembles de données manuels que nous utilisions auparavant pour faire fonctionner les systèmes en difficulté.
Exemple — Données de test synthétiques
Analyse des écarts de couverture
Plutôt que de rechercher un pourcentage de couverture, que tout le monde sait être un indicateur faible, je peux orienter les outils d’IA vers un ensemble de modifications de code et demander quels chemins les tests existants n’explorent pas. Cela transforme la couverture d’un simple chiffre en une liste de tâches.
Impact estimé sur le ROI : premiers 6 mois
Les chiffres suivants doivent être considérés comme estimations illustratives, pas de références universelles. Les résultats réels dépendront de la base de référence de l'équipe, des outils, de la complexité de l'application et du niveau d'adoption.
Conception et maintenance des tests
- Temps par test :réduction d'environ 60 % — de 4 heures à 1,5 heure
- Heures annuelles économisées :environ 320 à 400 heures par ingénieur
Résultats de qualité
- Détection des défauts :+22 %
- Échappées de régression :-18%
- Assurer la stabilité :+12%
Vitesse de l’équipe
- Temps de cycle par fonctionnalité :-25%
- Cycle de revue de code :-15%
ROI net — exemple d’une équipe QA de 6 personnes
- Coût estimé des outils :~15 000 $/an
- Valeur annuelle estimée :~110 000 $ US, équivalent à environ 1 ETP
- Période de remboursement estimée :~1,6 mois
L’important n’est pas que chaque équipe atteigne ces chiffres exacts. La question utile est de savoir si l’équipe peut établir une référence et démontrer une amélioration mesurable après adoption.Pour les organisations souhaitant valider ces gains de performance dans des conditions de production à grande échelle, les tests de performance et de scalabilité garantissent que vos améliorations de qualité tiennent sous une charge réelle.
Modes de défaillance critiques
Là où cela échoue encore
Je ne veux pas que cela ressemble à une page commerciale, alors voici l’autre réalité honnête.
Le problème d’oraclen’a rien changé. L’IA peut générer un test toute la journée, mais décider si le comportement qu’elle observe est correctrepose toujours sur une personne ou une spécification en qui vous avez réellement confiance. Le modèle ne sait pas ce que votre produit est censé faire ; il sait quel texte suit généralement un autre texte.
Déclarations hallucinatoiressont réelles et sournoises. Le modèle produira une assertion qui semble tout à fait raisonnable — noms de méthodes corrects, valeur attendue plausible — mais qui est simplement fausse. Si vous intégrez du code de test généré sans lire chaque assertion, vous finirez par déployer un test qui passe pour une mauvaise raison.
Non-déterminismedans l’outil lui-même complique la révision. Exécuter la même commande deux fois peut générer du code différent. Cela complique la situation lorsque l’ensemble de votre processus repose sur des modifications diffables et révisables dans le contrôle de version.
Limites du contextesignifie que l’outil comprend rarement l’ensemble de votre système, vos obligations en matière de conformité, ou l’historique organisationnel derrière une exigence qui semble étrange. Il optimise la requête qui lui est présentée.
Et il y a le question de donnéesEnvoyer du code propriétaire ou des exigences non publiées à un modèle tiers peut violer discrètement vos propres politiques. Avant d’adopter quoi que ce soit, vérifiez précisément où vos données sont envoyées et qui peut y accéder.
Comment détecter les modes de défaillance
Une revue mensuelle allégée peut détecter la plupart de ces problèmes sans créer un autre processus dont personne n’a le temps.
Mode de défaillance | Vérification rapide |
Le problème Oracle | Choisissez 5 tests. Pouvez-vous expliquer pourquoichaque assertion existe-t-elle ? |
Assertions Hallucinées | Vérifiez les noms des méthodes et les valeurs attendues par rapport à l’API/exigence réelle. |
Non-déterminisme | Exécutez la même requête deux fois. Les résultats sont-ils suffisamment cohérents pour être examinés ? |
Lacunes contextuelles | Examinez les scénarios manqués ce mois-ci et ajoutez le contexte pertinent au prochain prompt. |
Revue de guérison | Vérifiez si un test corrigé a ensuite été associé à un défaut réel. |
Actualité des données | Confirmez que les données synthétiques représentent toujours les modèles actuels de production. |
Temps :Moins de 30 minutes par mois.
Métrique de réussite :Aucune surprise de production inattendue causée par un test généré ou modifié par IA non relu.
Guide de mise en œuvre
Un chemin de déploiement qui ne fera pas tout exploser
Si je devais constituer une équipe à partir de zéro sur ce sujet, je procéderais dans cet ordre et résisterais à l’envie de passer directement aux étapes suivantes.
1. Rédaction assistée
L’IA rédige les cas de test et le code ; un humain vérifie tout avant la fusion.
Pourquoi commencer ici :Faible risque, retour sur investissement immédiat, et cela permet à l’équipe de se familiariser avec les situations où l’outil est fiable.
2. Automatisation de la maintenance
Activez les localisateurs auto-correctifs et la détection des tests instables, avec chaque modification automatisée enregistrée et examinée selon un calendrier.
3. Exécution intelligente
Ajouter une sélection de tests basée sur les risques afin que chaque commit exécute le sous-ensemble le plus pertinent et que la suite complète s’exécute chaque nuit.
4. Analytique
Laissez l’IA résumer les tendances de qualité et signaler les risques de lancement, puis intégrer ces informations dans la planification.
Erreur courante
L’erreur que j’ai observée chez d’autres équipes est de passer directement à la phase trois avant que personne ne fasse confiance aux outils de la phase un. Lorsque la chaîne de traitement fait alors un mauvais choix et qu’un défaut s’échappe, la confiance s’effondre et toute l’initiative s’arrête.
Que faire à la place :Gagnez la confiance progressivement. Commencez par un travail assisté par l’IA, mesurez les résultats, introduisez une automatisation contrôlée, puis seulement permettez à l’IA d’influencer les décisions d’exécution.
Gouvernance à privilégier
1. Propriété des artefacts et processus de révision
Chaque artefact généré par l’IA doit avoir un propriétaire humain nommé.
Le flux de travail doit être :
Génération IA → revue QE → correction → approbation → fusion → suivi
Le testeur doit rester responsable de la logique finale des tests, des assertions, des règles métier et des implications en matière de sécurité.
2. Piste d’audit autoréparatrice
Chaque action de guérison doit enregistrer :
- Localisateur original
- Nouveau localisateur
- Raison de la guérison
- Test affecté
- Horodatage
- Construire/lancer
- Examinateur
- Statut d'approbation finale
Une action corrective qui ne peut être expliquée par la suite ne doit pas être considérée comme une amélioration d'automatisation réussie.
3. Structure de versionnage des invites
Les invites doivent être considérées davantage comme des ressources d’ingénierie que comme des messages de chat temporaires.
Une structure simple pourrait être :
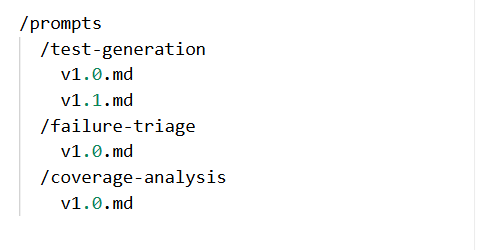
Chaque changement doit consigner ce qui a changé et pourquoi.
4. Matrice de classification des données
Type de données | Utilisation de l’IA |
Informations publiques | Généralement faible risque |
Informations internes non sensibles | Outils d’entreprise approuvés |
Code source confidentiel | Modèle/environnement approuvé uniquement |
Données client/PII | Évitez ou anonymisez |
Identifiants/Secrets de production | Ne jamais envoyer aux modèles d’IA |
La politique exacte doit toujours respecter les exigences de sécurité et de conformité de l'organisation.
5. Tableau de bord des indicateurs de réussite
Ne mesurez pas le succès par le nombre de requêtes ou de tests générés.
Parcours :
- Temps de création du test
- Heures de maintenance de l'automatisation
- Taux d’acceptation des tests générés par l’IA
- Taux de détection des défauts
- Défauts corrigés
- Durée du cycle de régression
- Taux de tests instables
- Fréquence d’auto-réparation
- Effort de revue humaine
- Libérer la confiance
L’objectif est de démontrer que l’IA améliore les résultats en ingénierie plutôt que de simplement générer davantage d’artefacts.
Conclusion et prochaines étapes
1. Augmentation stratégique
Le modèle le plus efficace n’est pas une opposition entre l’IA et les humains. C’est l’IA qui prend en charge une plus grande part des tâches mécaniques tandis que les ingénieurs qualité consacrent davantage de temps aux risques, à l’architecture, au comportement métier et au jugement. Ce changement rend le rôle de l’ingénieur qualité plus précieux, pas moins.
2. Confiance acquise > Confiance dès le premier jour
N’attendez pas qu’une équipe fasse confiance à l’IA simplement parce qu’une démonstration a semblé impressionnante. Commencez par une rédaction assistée, mesurez les résultats, introduisez une automatisation contrôlée, puis développez uniquement lorsque les preuves le justifient.
3. Mesurez les résultats, pas l’activité
« 500 tests IA générés » est une métrique vaniteuse. « Défauts échappés réduits de 22 % » est une stratégie qualité.
Les équipes tirant de la valeur de l’IA considèrent chaque résultat comme un premier jet, maintiennent une personne responsable de chaque décision et mesurent les résultats réels plutôt que de compter combien de tests le robot a rédigés cette semaine.
Pour les organisations souhaitant développer cette capacité à grande échelle, la prochaine étape n’est pas simplement d’acheter un autre outil d’IA. Il s’agit de construire la bonne combinaison de Ingénierie qualité, automatisation, gouvernance et résultats commerciaux mesurables pilotés par l’IA.
Explorez le Services d’ingénierie qualité TO THE NEW pour en savoir plus sur l’assurance qualité assistée par l’IA et l’automatisation intelligente des tests, ou pour contacter l’équipe afin d’obtenir une consultation en ingénierie de la qualité.
Commencez petit, consignez tout, et laissez la confiance acquise fixer le rythme.